監視とは
monitoring(モニタリング、監視)は、システムの状態や性能、ログを継続的に観測し、異常を検知・通知する運用です。テレメトリーを集めるだけでなく、利用者への影響を判断し、担当者が調査・復旧できるところまでを含みます。
監視は「ダッシュボードを眺め続ける作業」ではありません。正常性をシステムで継続評価し、行動が必要な症状だけを適切な相手へ通知します。長期傾向、容量計画、変更比較、インシデント調査にも使います。
アラートは原因を断定するものではありません。「利用者に何が起きているか」という症状を早く捉え、メトリクス・ログ・トレースと変更履歴から原因候補を絞ります。
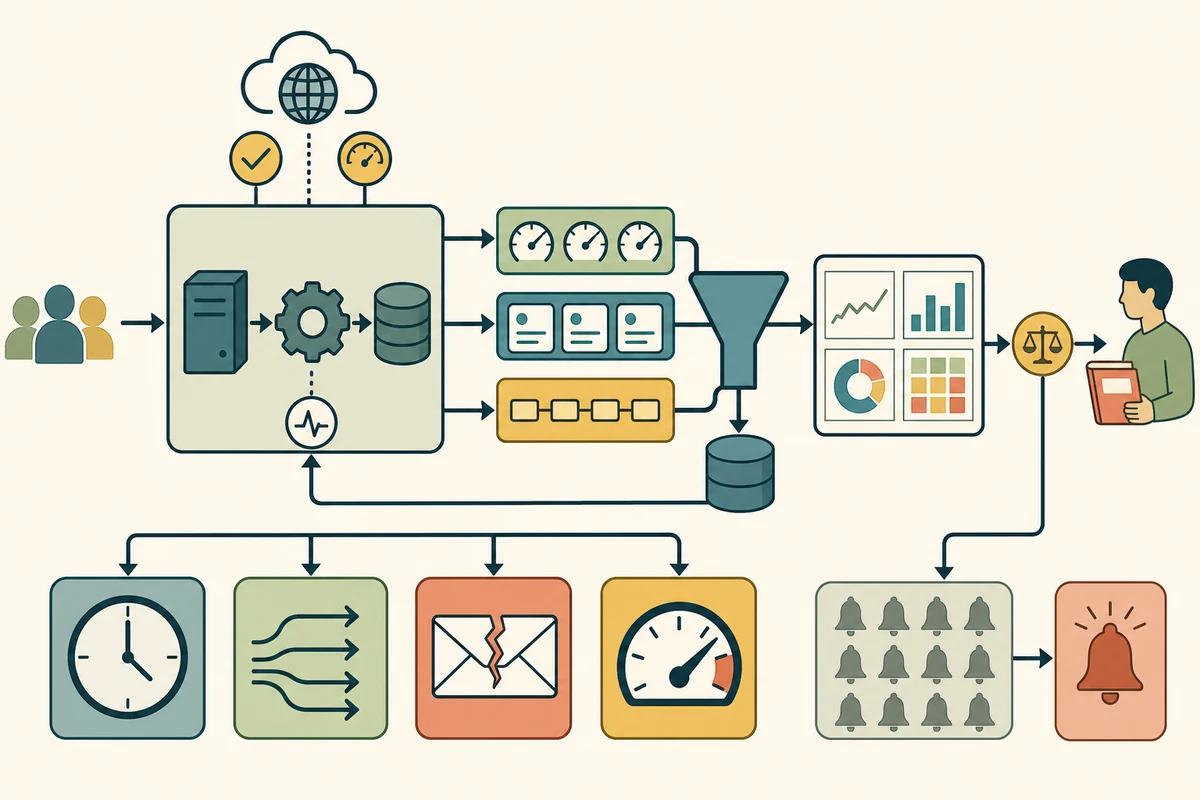
監視の一連の構成
アプリケーション、OS、ネットワーク、外部試験通信が信号を出します。
エージェント・収集基盤でバッファー、一括処理、加工し、バックエンドへ送ります。
保持期間、サンプリング、索引、コストを決めて検索可能に保存します。
ダッシュボードでサービス段階、依存先、配備時刻を一緒に見ます。
症状、持続時間、影響範囲、SLOを条件に通知先と優先度を選びます。
手順書、担当責任、当番対応、上位担当への連絡、事後検証を用意します。
メトリクス・ログ・トレース
メトリクスは要求数、エラー率、CPU、遅延分布等を時間窓で集約した数値です。傾向とアラートに向きますが、一件の要求の細部は失われます。
ログは時刻付きイベントレコードです。エラーメッセージや業務イベントの詳細を残せますが、自由テキストだけでは検索・相関が難しくなります。構造化されたフィールドと要求IDを使います。
トレースは一つの要求が複数サービスを通る経路をスパンの親子関係で表します。どの依存先で時間やエラーが生じたかを追えます。三信号をトレースID等で相関できると調査しやすくなります。
ブラックボックスとホワイトボックス
ブラックボックス監視は利用者と同じ外側から、接続、ログイン、購入等が成功するか測ります。内部CPUが正常でも利用者が失敗している状態を検出できます。
ホワイトボックス監視はアプリケーション内部の待ち行列、キャッシュ該当、スレッド、データベース接続等を観測します。原因調査に強い一方、内部が正常に見えてもエンドツーエンドが壊れる場合があります。両方を組み合わせます。
四つの四つのゴールデンシグナル
遅延は処理時間で、成功と失敗の遅延を分けます。トラフィックは要求数やトランザクション量等の需要です。エラーは明示的失敗だけでなく、遅過ぎる・内容が誤る等の方針上の失敗も含みます。
飽和度は制約リソースがどれほど満杯かです。CPU 100%だけでなく、メモリー、ディスク、接続プール、待ち行列、帯域幅、割り当て量を見ます。限界前に遅延が悪化することがあります。
平均だけを見ない
平均遅延が低くても、一部利用者だけ非常に遅い場合があります。パーセンタイル、分布、最大、サンプル数を見ます。低トラフィック時の割合は一件で大きく変わるため、件数と一緒に判断します。
成功率も全エンドポイント合計だけでなく、重要操作、地域、クライアント種類、依存先で分けます。ただし次元を増やし過ぎると種類数とコストが急増します。
SLI・SLO・SLA
SLIは利用者が受けたサービス動作の測定値、SLOはその目標です。SLAは提供者と利用者の合意で、未達時の条件を含む場合があります。
監視はSLOの消費速度を見て、本当に利用者影響が大きい事象を優先します。内部リソース値だけでなく、利用者視点のSLIをアラートへ結び付けます。
アラートを行動へ結び付ける
ページは即時対応が必要な重大症状、対応票は営業時間内の調査、ダッシュボードは観察というようにチャネルを分けます。アラートにはサービス、症状、開始時刻、影響、関連ダッシュボード、手順書、直近変更を含めます。
CPUが少し高い等の原因候補だけでページするとノイズになります。「利用者要求の失敗率がSLOを急速に消費」のように症状を中心にします。
アラート疲労を防ぐ
同一インシデントから大量アラートが出ないよう重複排除、グループ化、依存先抑制を使います。閾値の上下で通知が揺れないよう持続時間とヒステリシスを置きます。
各アラートに所有者を割り当て、対応されなかったアラート、誤報、重複を定期的に削除・改善します。一時停止には期限と理由を持たせます。
時刻と文脈
複数サーバーの時計がずれるとログとトレースの順序が崩れます。時刻同期を監視し、イベント時刻と受信時刻を区別します。タイムゾーンは保存時に統一し、表示時に変換します。
サービス名、バージョン、環境、地域、インスタンス、要求ID等のリソース属性を揃えます。個人情報や秘密情報をラベル・ログへ入れません。
サンプリングと欠測
全トレース・ログを永久保存するとコストが増えます。通常トラフィックをサンプルしつつエラー・遅いトレースを高率で残す方法があります。ただしサンプリング後のデータから正確な件数を推定できるか確認します。
テレメトリーの処理経路自体も監視します。「値がゼロ」と「収集基盤へデータが届いていない」を区別できるよう、ハートビートと取り込み遅延の指標を用意します。
変更と監視を結ぶ
デプロイ、設定変更、機能リリース、インシデント開始を時系列へ記録します。異常がいつ・どのバージョンから始まったかを比較できます。
監視結果を容量、試験、切り戻し条件へ戻します。事後レビューでは検知できたか、通知先は正しかったか、手順書が使えたかも改善します。
監視はシステムから信号を集め、利用者症状を判断し、必要な人が行動できる形にする運用です。メトリクス・ログ・トレースとブラックボックス・ホワイトボックスを組み合わせ、ノイズを減らします。
monitoringの定義、black-box・white-box、四つのgolden signals、alert設計:Google SRE Book「Monitoring Distributed Systems」、metrics・logs・tracesとobservability:OpenTelemetry Observability Primer