文字コードとは
文字コードは、文字をコンピューターで扱うための番号やバイト列の規則を指す日本語の総称です。会話では、文字に番号を割り当てる文字集合と、その番号をバイト列にする文字エンコーディング(character encoding/キャラクター・エンコーディング)の両方を含む意味で使われます。
この二つを厳密に区別する場面では、Unicodeのように文字と符号位置を対応させる規則を文字集合、UTF-8のように符号位置を保存・通信用のバイト列へ表す規則を文字エンコーディングと呼び分けます。
encode(エンコード/符号化)は文字列からバイト列へ、decode(デコード/復号)はバイト列から文字列へ進む処理です。両側が同じ規則を使わなければ、元の文字へ戻りません。
文字化けは「フォントが壊れた」現象とは限りません。同じバイト列を、保存時と違うエンコーディングで復号したときに起こるのが典型です。
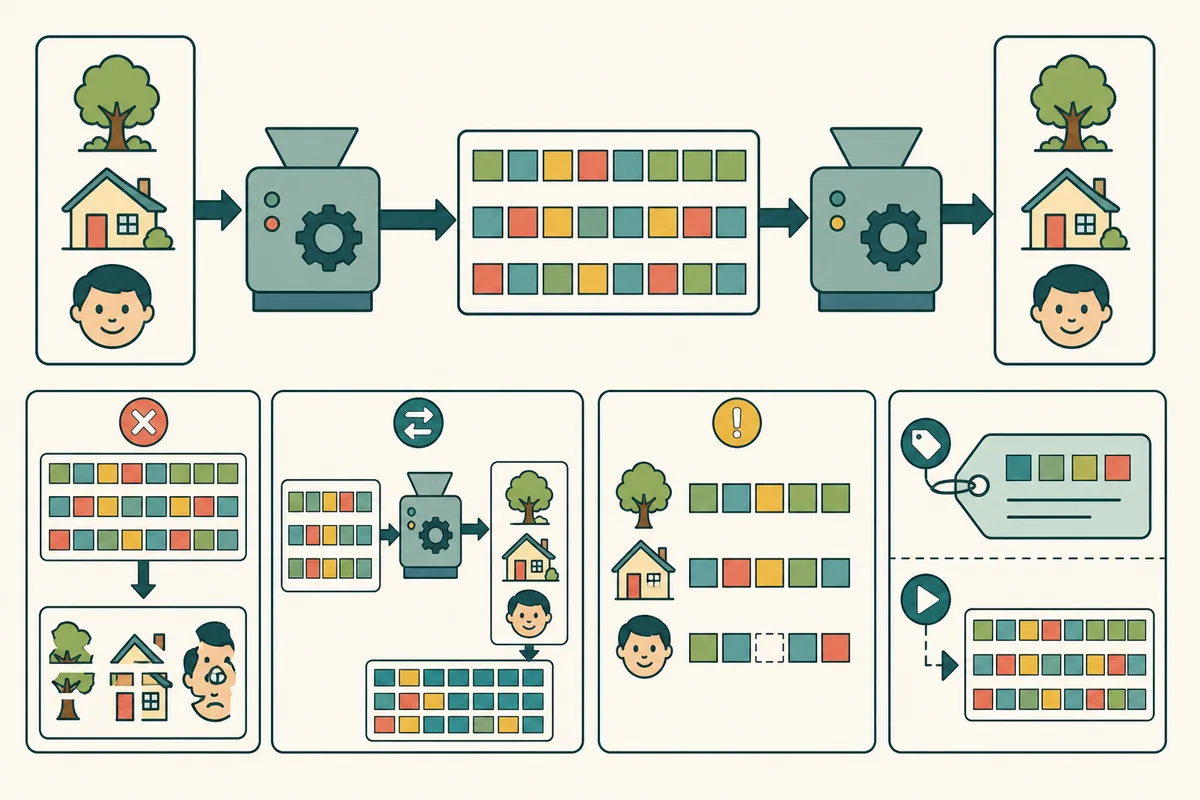
文字集合とエンコーディングは役割が違う
Unicodeのように、抽象文字と符号位置を定めます。
UTF-8のように、番号を保存・通信するバイト列へ変えます。
符号位置に対応する字形を持ち、文字を表示します。エンコーディングではありません。
同じバイトでも規則が違えば別の文字になる
Shift_JIS、EUC-JP、ISO-2022-JP、Windowsのコードページなど、歴史的な方式には異なる対応表があります。同じ値のバイトが、方式によって別の文字や先頭バイトとして解釈されます。
バイト列だけから方式を常に一意に推測することはできません。HTTPヘッダー、HTMLの文字集合、XML宣言、ファイル形式の取り決め、送信者との合意を優先します。推測結果を確定情報のように扱いません。
宣言と実体を一致させる
「UTF-8と書いてある」ことと「実際のバイトがUTF-8である」ことは別です。保存時の方式、サーバーが送るMIMEタイプと文字集合、読み手の復号方式をそろえます。
BOMは一部のUnicode方式で識別やバイト順判定に使われますが、どのファイルにも必須ではありません。方式の仕様がBOMを許すか、データとして残すかを確認します。
エンコーディング変換は「復号してから再符号化」
transcoding(トランスコーディング/文字符号変換)では、元バイトを元方式で文字列へ戻し、その文字列を変換先方式で再びバイト化します。元の方式を誤れば、その後にUTF-8へ保存しても文字化けが固定されます。
変換前の原本を残し、入力方式を明示して、変換後を再復号して確認します。見た目だけでなく、機種依存文字、結合文字、改行、NUL、往復変換で失われる文字も検査します。
表現できない文字と不正なバイト列
古い方式の文字集合にない文字を符号化すると、エラー、代替文字、数値参照などになります。黙って?へ置き換えると、異なる氏名や識別子が同じ値になり、元へ戻せません。
復号側では、規則に合わないバイト列を置換文字へする方式と処理を止める方式があります。表示文なら置換が役立つ場合がありますが、署名、設定、識別子、セキュリティ検査ではfatalエラーとして拒否すべき場面があります。
文字化けを直す順序
- 原本のバイトを保存する文字化け状態で上書きせず、ハッシュや複製を取ります。
- 作成元と宣言を調べるアプリ、OS、HTTPヘッダー、メタ情報、過去の運用を確認します。
- 候補ごとに復号する不正列の有無と、文脈上自然な文字列になるかを比較します。
- UTF-8などへ一度だけ変換する正しく復号できた文字列から再符号化し、往復確認します。
エンコーディングの不一致は安全性にも関わる
検査器と実行器が別の方式で同じバイトを読むと、片方には見えない区切りや命令がもう片方で現れることがあります。WHATWG Encoding Standardは、ASCIIの区切りが不正な多バイト列に隠れないよう復号動作を定めています。
新しいWeb形式はUTF-8へ統一し、入力方式を利用者が自由に上書きできる設計を避けます。既存データとの互換が必要な境界だけで古い方式を受け、内部では一つの表現へ正規化します。
文字エンコーディングは文字列とバイト列の往復規則です。文字集合・フォント・データ形式と分け、宣言と実体を一致させ、不明なバイトを推測のまま上書きしません。
Webでのencoding名・復号・エラー処理:WHATWG Encoding Standard/Unicodeの文字モデル:The Unicode Standard