UTF-8とは
UTF-8(Unicode Transformation Format – 8-bit/ユニコード・トランスフォーメーション・フォーマット・エイトビット/ユーティーエフ・エイト)は、Unicodeの符号位置を1~4バイトで表す、Webで標準的に使われる文字エンコーディングです。
符号位置の値が小さいほど短いバイト列にし、ASCII範囲は同じ値の1バイトで表します。日本語や多くの絵文字は複数バイトですが、バイト数は文字の表示幅や重要度を表しません。
UTF-8は文字を増やす標準ではなく、Unicodeの符号位置を保存・通信できるバイト列へ変換する規則です。
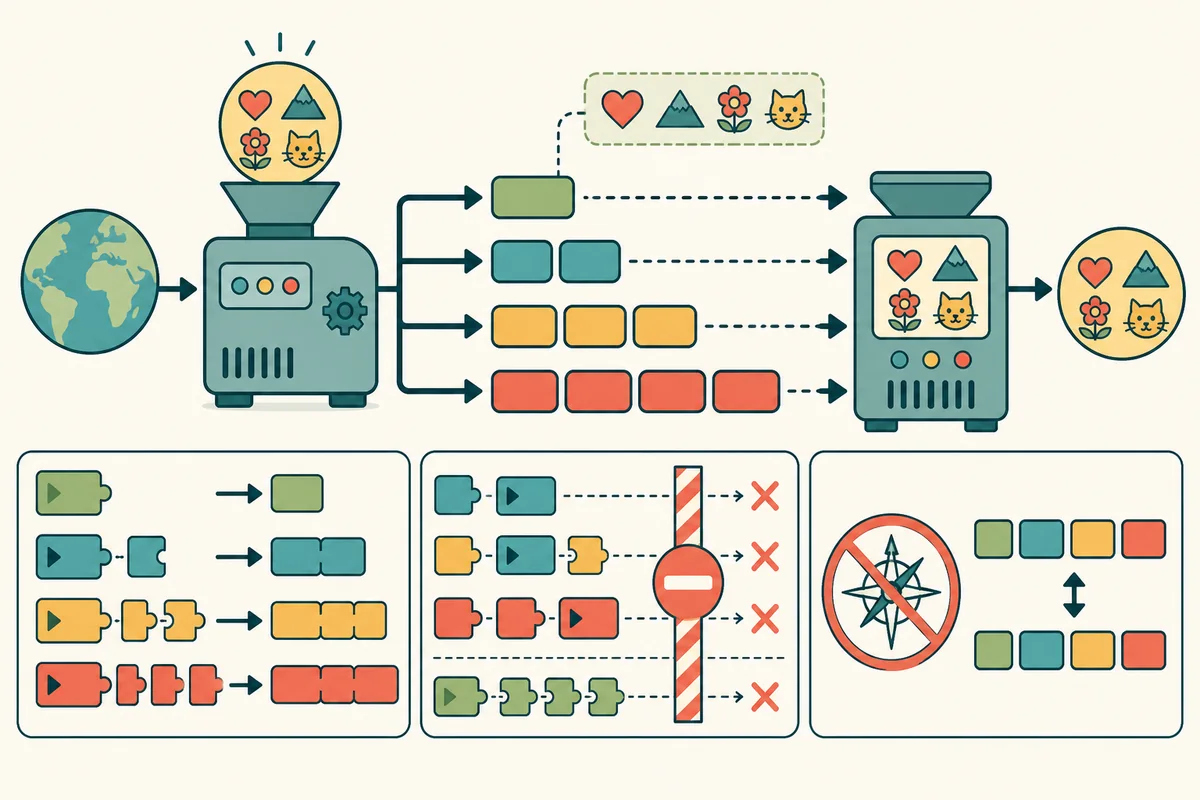
1〜4バイトの可変長
ASCIIと同じ範囲です。先頭ビットは0で、値もASCIIと一致します。
先頭バイトが長さを示し、続く一個が継続バイトになります。
多くの日本語文字がこの範囲です。サロゲート領域は符号化しません。
一部の追加漢字や多くの絵文字などを表せます。
先頭バイトが長さを示し、継続バイトが値を運ぶ
1バイト文字は0xxxxxxx、2〜4バイト列の先頭は110、1110、11110で始まります。後続する継続バイトは10xxxxxxです。復号器はこの形から文字境界と必要な長さを判断します。
途中のバイトから読んでも、継続バイトか先頭バイトかを見分けやすい設計です。ただし、文字列の途中を任意のバイト位置で切れば不完全な列になります。切り出しは文字境界で行います。
ASCIIとの互換性
ASCII範囲の符号位置は、UTF-8でも同じ1バイト値です。英数字だけのASCIIファイルは有効なUTF-8でもあります。この性質により、既存のプロトコル区切りやプログラムを壊しにくくしました。
一方、ASCII対応だけの入力欄が日本語を受け付けるわけではありません。「ASCII列がUTF-8として有効」と「その仕様がUnicode文字を許可する」は別の判断です。
不正なバイト列を受け入れない
必要な継続バイトが足りない、継続バイトだけが現れる、5バイト以上の旧形式、サロゲート値、U+10FFFFを超える値は有効なUTF-8ではありません。また、本来1バイトで表せる値を2バイト以上にしたoverlong sequence(オーバーロング・シーケンス/過長列)も不正です。
不正列を複数の解釈で許すと、検査器と実行側で区切り文字の見え方が変わり、セキュリティ問題になります。処理方針は、置換文字U+FFFDへ置き換えるか、fatalエラーとして拒否するかを明示します。
BOMはバイト順の指定に不要
BOM(Byte Order Mark/バイト・オーダー・マーク/ボム)として先頭にU+FEFFのUTF-8列を置くファイルがあります。しかしUTF-8はバイト単位の並びが固定なので、UTF-16のようなエンディアン判定は不要です。
先頭BOMを署名、CSVの最初の見出し、コマンド入力の一部として誤処理すると不具合になります。受け入れるか除去するかは形式の仕様に従い、データ途中のU+FEFFまで無条件に削除しません。
文字数とバイト数は一致しない
UTF-8の一符号位置は1〜4バイトです。さらに、利用者が一文字に見える書記素クラスタは複数符号位置から成り得ます。したがって、バイト数・符号位置数・書記素数・表示幅は別々に測ります。
データベース列、HTTP本文長、ファイル容量はバイト単位になることがあります。画面の入力文字数は書記素単位が自然です。APIの上限に「100文字」とだけ書かず、何を数えるか決めます。
Webで使うときの指定
HTMLは先頭付近の<meta charset="utf-8">、HTTPは必要に応じてContent-Typeのcharsetパラメーターで示します。現代の新しいWeb形式やプロトコルではUTF-8を選ぶのが基本です。
保存時の実バイト列と宣言が違えば文字化けします。エディターの表示名だけでなく、実際に保存されたバイトと応答ヘッダーを確認します。
UTF-8はUnicode符号位置を1〜4バイトへ変える可変長方式です。ASCIIは同じ1バイト、不正列と過長列は拒否し、文字数とバイト数を同一視しません。
UTF-8の形式と禁止列:RFC 3629/Web実装の復号規則:WHATWG Encoding Standard