URLエンコードとは
URLエンコードは、URLで直接使いにくい文字を、決められたバイト列とパーセント記号で表す処理です。ここでいうURL(Uniform Resource Locator/ユニフォーム・リソース・ロケーター)の変換は、一般にパーセントエンコーディングを中心にします。
ただし「URLエンコード」という単一の関数をURL全体へかけるのではありません。スキーム、ホスト、パス、問い合わせ、断片では、構造を作る記号とデータとして扱う文字が違います。
変換対象はURL全体ではなく、URLへ埋め込む一つの成分です。成分を選び、その文字列をUTF-8などのバイトへしてから、必要なバイトだけを%HHへします。
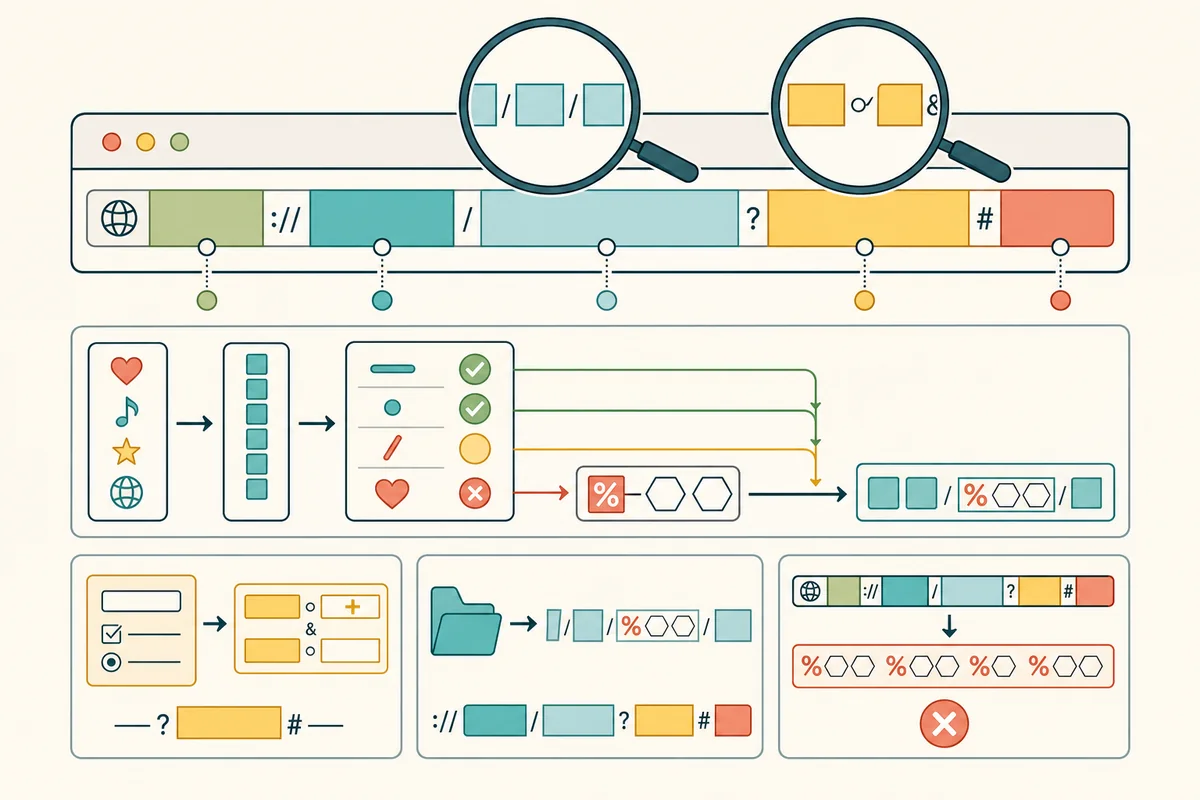
URLの成分ごとに役割がある
国際化ドメイン名はパーセントエンコードではなく、URL StandardとIDNAの処理を通ります。
/は区切りです。データ中の斜線を同じ扱いにするかは設計で決めます。
?以後の構文です。URLSearchParamsはフォーム形式の規則を使います。
#以後で、通常HTTP要求のサーバーへは送られません。
文字からバイトへして、そのバイトを表す
日本語の一文字をそのまま「%と番号一個」にするわけではありません。まずUTF-8などで複数のバイトへし、各バイトを%HHで表します。そのため、一文字が複数のパーセントエンコード済みバイトになります。
現代のWebではUTF-8を使うのが基本です。古い文字エンコーディングを混ぜると、送信側と受信側で元の文字が一致しません。
予約文字は「使えない文字」ではない
:、/、?、#、[、]、@などはURL構造に使うreserved character(リザーブド・キャラクター/予約文字)です。構造として使うときはそのまま、成分内のデータとして使うときは文脈に応じて符号化します。
スキームの後の:やパスの区切り/まで符号化すると、ブラウザはURLの構造を認識できません。既に組み立てたURL全体をencodeURIComponentへ渡さない理由です。
空白は常に+になるわけではない
アプリケーション/x-www-form-urlencoded形式では、空白を+として表す規則があります。HTMLフォームやURLSearchParamsの問い合わせ直列化で見かけます。
一方、一般のパス成分にある空白は通常%20です。問い合わせ文字列を手作業で分解し、どの場所でも+を空白へ変えると、本来のplus記号を失う場合があります。
JavaScriptのAPIを目的で選ぶ
| API | 対象 | 注意 |
|---|---|---|
encodeURI() | 既にURLらしい文字列 | 構造用の予約文字を広く残します。個々の値には緩すぎます。 |
encodeURIComponent() | パスセグメントや問い合わせ値など一成分 | URL全体へ使うと区切りも変わります。 |
URL | URLの解析と組み立て | 基礎URLや各特性を使い、文字列連結を減らせます。 |
URLSearchParams | 問い合わせの名前と値 | フォームURLエンコーディングの空白規則を使います。 |
二重符号化と二重復号を避ける
既に%2Fとなった文字列をもう一度符号化すると、%自体が%25となり、%252Fのようになります。どの層が生の文字列を受け取り、どの層が一度だけ符号化するかを決めます。
受信側も一度復号した値を別層が再度復号すると、検査時には無害だった表現から区切りやパス横断要素が現れることがあります。復号回数を固定し、復号後の値を検証します。
URLエンコードは、URLの一成分へ文字列を安全に入れるための処理です。成分と文字エンコーディングを決め、予約文字・空白・既変換値を文脈に合わせて一度だけ扱います。
URLの成分・percent-encode set・form URL encoding:WHATWG URL Standard