Webトラッキングとは
Webトラッキングは、複数ページやサイトでの閲覧・操作を記録し、利用者の行動を分析・識別することです。英語ではWeb tracking(ウェブ・トラッキング)と表します。
ページ表示、リンククリック、検索、購入、スクロール、広告表示などのイベントへ時刻、ページ、リファラー、機器情報、識別子を結び付けます。品質改善、セキュリティ、不正防止、広告、個人化など目的はさまざまです。
一つのアクセスログを持つことと、複数文脈の行動を同じ利用者として長期間結び付けることは同じではありません。誰が、どの範囲を、何のために関連付けるかを見ます。
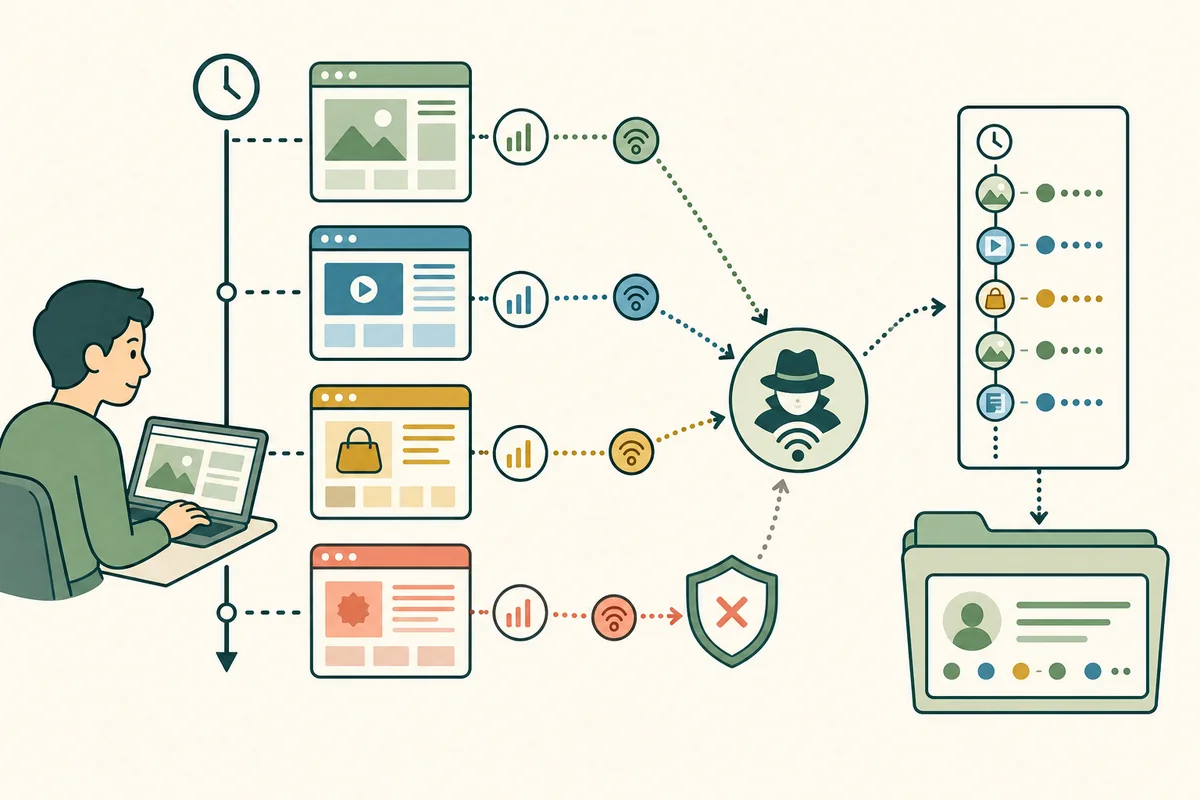
追跡範囲を文脈で分ける
エラー、表示時間、クリックなどを現在のネットワークinteraction内で処理する。
再訪、導線、購入までを自社サービスの識別子へ結び付ける。
共通スクリプト・画素・広告要求などから複数文脈のイベントを集める。
ログイン、emailハッシュ、広告ID、推定モデルでPCとスマートフォンを結び付ける。
ログイン場所、機器変化、操作パターンをリスク判定へ使う。
目的達成後の削除、集計化、第三者提供、利用者のアクセス・opt-outを管理する。
Cookieだけを消しても追跡手段は残る
Cookie、localStorage、アカウントログイン、URL問い合わせへ識別子を足すlink decoration(リンク・デコレーション)、サーバーログ、IPアドレス、ブラウザー指紋などを組み合わせられます。
一方、同じIPを共有する家庭や会社、変動IP、NATがあるため、IPだけで一人を確定はできません。複数信号を確率的に結ぶことがあります。
収集・利用・共有を分けて読む
イベントを受け取る収集、分析・個人化に使うuse、別主体へ渡す共有は別段階です。プライバシー説明ではデータ項目、目的、保持期間、委託先・第三者、選択方法を対応させます。
「匿名統計」と記しても、生のイベントや一意なIDを保持していれば再識別リスクがあります。集計前のデータへ誰がアクセスできるかも確認します。
ブラウザーの保護は手段ごとに働く
第三者Cookieの制限、ストレージの分割、追跡ドメインのブロック、リファラー制限、フィンガープリンティングに利用できる情報の削減などが使われます。プライベート閲覧は端末に残す履歴を減らしますが、接続先が受け取る情報をすべて止める機能ではありません。
Web追跡を評価するときは「Cookieを使うか」だけでなく、識別子の由来、結び付ける文脈、利用目的、保持時間、共有先、利用者が拒否・削除できる範囲を並べます。
trackingのcontextとdata処理の確認資料:W3C「Tracking Compliance and Scope」