圧縮とは
圧縮(compression/コンプレッション)は、同じ情報をより少ないデータ量で表し、保存容量や転送量を減らす処理です。元の並びにある繰り返しや偏りを見つけ、短い参照や短い符号へ置き換えます。
圧縮後のデータは、その方式を知るデコーダーで展開(decompression/デコンプレッション)して利用します。単にバイトを削除するのではなく、復元に必要な規則と情報を圧縮ストリームへ持たせます。
圧縮形式は「小さいデータ」という意味ではありません。入力の性質、設定、ヘッダーを含むため、短い入力や既に圧縮済みの入力では、かえって大きくなることもあります。
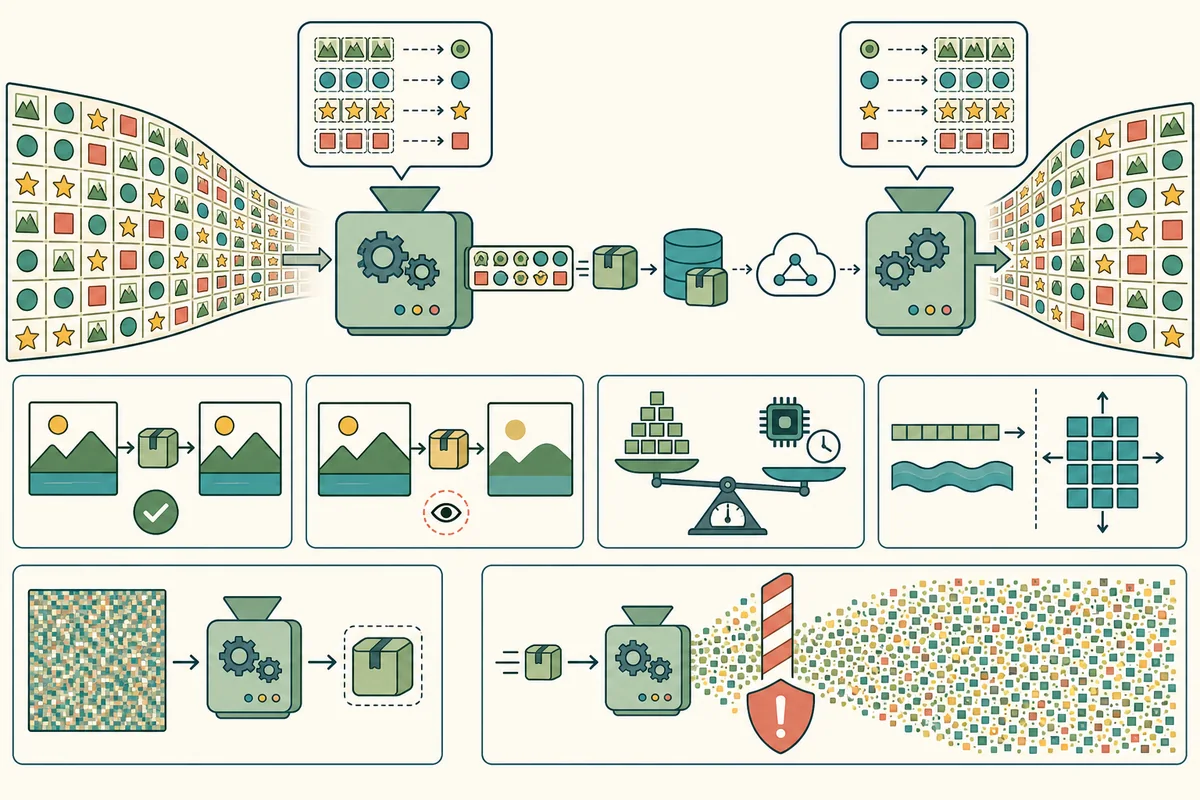
可逆圧縮と非可逆圧縮
展開後のバイト列が元と完全に一致します。テキスト、プログラム、データベース、保管に必要です。
知覚しにくい情報などを捨ててさらに減らします。画像・音声・動画で使われます。
以前に現れた列や辞書の語を、距離と長さなどの短い表現へします。
よく現れる記号を短く、少ない記号を長く表します。
可逆なら「元と似ている」ではなくバイト単位で同じ
設定、プログラム、実行ファイル、署名対象、医療数値などは一ビットの違いでも意味が変わるため、可逆圧縮を使います。展開後のハッシュやチェックサムを照合すれば、復元したデータの一致を確認できます。
非可逆圧縮は品質設定で捨てる量を変えます。一度失った情報は、後から高品質設定へ変えても戻りません。編集用原本を可逆または非圧縮で残し、配布用を別に作ります。
圧縮率・速度・メモリー・待ち時間のトレードオフ
compression ratio(コンプレッション・レシオ/圧縮率)は、圧縮前後の大きさ関係を示します。ただし「70%圧縮」が元の70%になった意味か、70%減った意味か曖昧なので、元大きさ・圧縮後大きさ・比率の式を併記します。
広い探索範囲、高い品質、複雑なモデルは小さくできる可能性がある一方、CPU時間とメモリーを使います。サーバーが要求ごとに動的圧縮する場合は、転送短縮より圧縮待ちが長くならない設定を測定します。
ストリーミングとランダムアクセス
ストリーミング方式は入力を順に読み、限られたメモリーで圧縮・展開できます。ただし後半だけを読むために先頭から展開が必要な形式があります。
大きなデータで部分取得や並列処理が必要なら、独立ブロック、索引、チャンク単位の圧縮を使います。ブロックを小さくするとランダムアクセスしやすくなる一方、ブロック間の繰り返しを利用しにくくなります。
既に圧縮されたデータは縮みにくい
JPEG、動画コーデック、ZIP、暗号文などは、繰り返しや偏りが既に減っています。さらにgzipをかけてもほとんど縮まず、ヘッダー分だけ増えることがあります。
WebではHTML、CSS、JavaScript、JSON、SVGなどテキスト系を圧縮し、既圧縮画像は通常そのまま送ります。MIMEタイプだけでなく実際の形式と測定結果で判断します。
HTTPのコンテンツ符号化
クライアントはAccept-Encodingで受け入れ可能なコンテンツ符号化を示し、サーバーは選んだ方式をContent-Encodingへ書きます。Content-Typeは展開後の表現形式のままです。
同じURLでも圧縮方式ごとに応答のバイト列が変わるため、キャッシュはVary: Accept-Encodingを考慮します。圧縮済み大きさに対するContent-Lengthと、展開後大きさを混同しません。
展開量と秘密情報を守る
ごく小さな圧縮データが巨大に展開されるcompression bomb(コンプレッション・ボム/圧縮爆弾)があります。入力時の大きさだけで許可せず、展開後の上限、圧縮率、入れ子の深さ、CPU時間、保存先容量を制限します。
秘密情報と攻撃者が選べる文字列を同じ圧縮文脈へ入れ、暗号化後大きさを観測できると、秘密情報との一致度が大きさ差へ漏れる場合があります。認証トークン等を混在させない、圧縮を無効にする、要求ごとに隔離するなどプロトコルに合う対策を取ります。
圧縮はデータの偏りを短い表現へ変える処理です。可逆性、圧縮率、CPU・メモリー、ランダムアクセス、既圧縮形式、展開上限、秘密情報との同居を用途ごとに設計します。
HTTP content codingとAccept-Encoding:RFC 9110/代表的な可逆方式DEFLATE:RFC 1951