CSVとは
CSV(Comma-Separated Values/コンマ・セパレーテッド・バリューズ/シーエスブイ)は、値をカンマなどで区切り、行と列の表形式データを表すテキスト形式です。一行をレコード、区切られた各値をフィールドとして扱います。
表計算ソフト、データベース、業務システム間の受け渡しで広く使われます。単純に見えますが、フィールド内のカンマ、改行、引用符、文字エンコーディング、ヘッダー、空値の意味を合わせなければ正しく交換できません。
CSVは「画面に見える表」ではなく、レコードとフィールドを区切る文字列規則です。セル内の改行を含むフィールドがあれば、一つのレコードが物理的に複数行へまたがります。
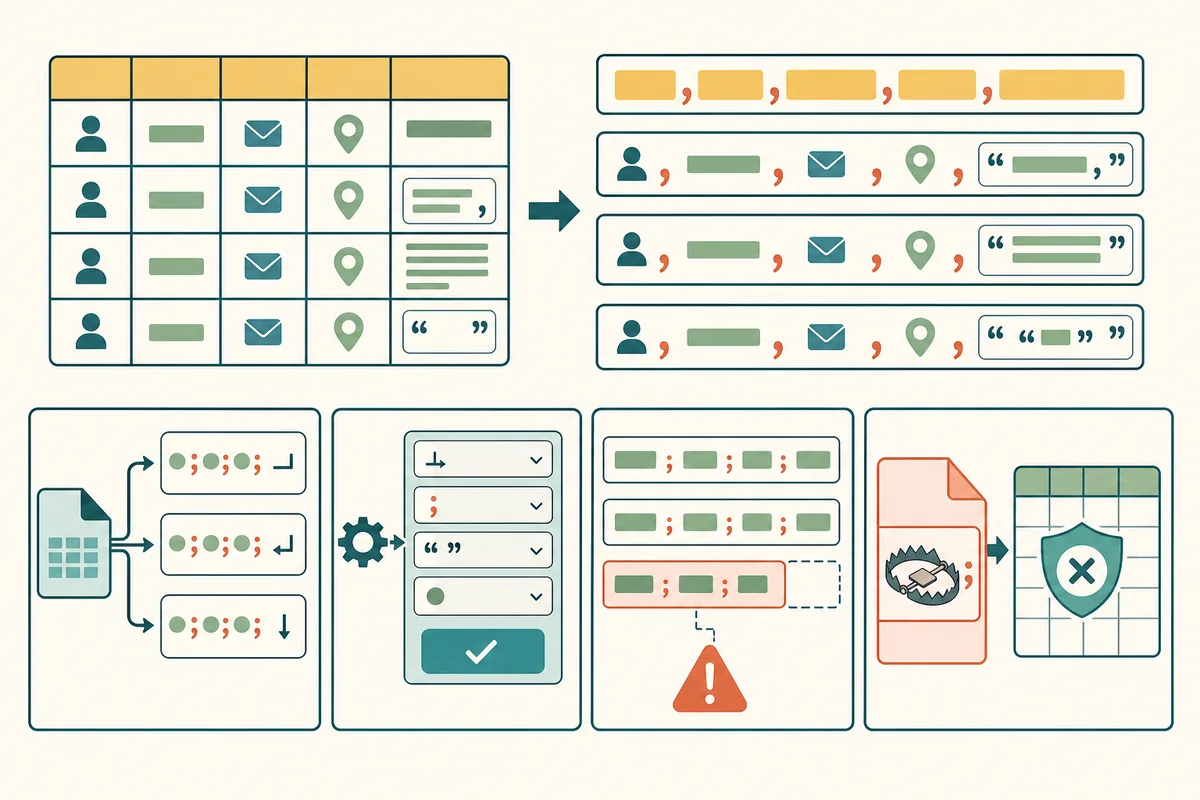
レコードとフィールドの基本
通常は改行で次のレコードへ進みます。末尾改行の有無は実装差があります。
カンマで次のフィールドへ進みます。空フィールドも位置を持ちます。
先頭レコードを列名として使うかは取り決めが必要です。
カンマ、改行、引用符を含むフィールドは二重引用符で囲みます。
引用符が必要なフィールド
name,address,note
山田,"東京都,千代田区","一行目
二行目"
佐藤,大阪府,"彼は""確認済み""と記録した"カンマを含む住所はフィールド全体を"..."で囲みます。フィールド内の改行も囲めば一つのフィールドとして保持できます。フィールド内の二重引用符は""と二個続けます。
単純なsplit(',')や一行ずつの読取りでは、引用符内のカンマ・改行を区別できません。CSV解析器を使い、レコード全体を状態を持って読みます。
RFC 4180は共通部分を文書化したもの
RFC 4180はカンマ、CRLF、任意ヘッダー、引用符の扱いとtext/csvを整理しています。ただしCSVには、現実のすべてのファイルを一つに統一する絶対的な仕様があるわけではありません。
タブ区切りTSV、セミコロン区切り、独自エスケープ、空白の除去、末尾カンマ、コメント行などのdialect(ダイアレクト/方言)があります。拡張子だけで推測せず、区切り・引用符・エスケープ・改行を交換仕様へ書きます。
文字エンコーディングを別に決める
CSVの区切り規則だけでは、UTF-8、シフト_JISなどの文字エンコーディングを一意に決められません。送受信側でUTF-8へ統一し、BOMの有無も合意します。
表計算ソフトが地域設定から文字コードや区切りを推測する場合があります。自動で開いて文字化けしたら上書きせず、取り込み画面で方式と区切りを指定して確認します。
すべてのフィールドはまず文字列
CSV自体には数値、日付、真偽値、nullの型がありません。00123を数値として読むと先頭0が消え、長い識別番号は指数表示や丸めへ変わる場合があります。スキーマや列ごとの型を別途定めます。
空フィールドが空文字なのかnullなのか、列自体の欠落なのかもCSVだけでは決まりません。null用の表記を決める場合、その文字列が実データとして現れる可能性も考えます。
列数とヘッダーを検証する
RFC 4180は各レコードが同じフィールド数を持つことを想定します。少ない行を空フィールドで補うか、多い行を拒否するかを決め、黙って列をずらしません。
ヘッダー名の重複、前後空白、大小文字、改行混入も確認します。列位置だけに依存する処理では、提供側が列を追加したとき別の値を読み込まないようバージョンとスキーマを管理します。
表計算ソフトの数式注入
フィールドが=、+、-、@などで始まると、表計算ソフトが数式として実行することがあります。外部入力を含むCSVを人が開く場合、命令実行、外部参照、情報送信につながる可能性があります。
引用符で囲むだけでは、CSV解析器が引用符を外した後に数式として認識される場合があります。出力用途に合う安全化、信頼できないフィールドの明示、表計算ソフト側の保護設定を組み合わせます。
CSVはレコードとフィールドの区切り規則です。カンマ・改行・引用符を含むフィールドを正しく引用符で囲み、方言、文字エンコーディング、列型、null、表計算ソフトでの扱いを別に取り決めます。
record・field・引用符・header・text/csv:RFC 4180