Unicodeとは
Unicode(ユニコード)は、世界中の文字や記号へ共通の符号位置を割り当てる文字集合の標準です。日本語、ラテン文字、数学記号、絵文字などを、一つの番号体系の中で扱えるようにします。
Unicodeが決める中心は「どの文字を、どの符号位置として扱うか」です。ファイルへ何バイトで保存するかは、UTF-8などの文字エンコーディングが決めます。
Unicodeは字体の画像集ではありません。文字の抽象的な同一性、性質、並び方を定義し、実際の形はフォントと描画処理が作ります。
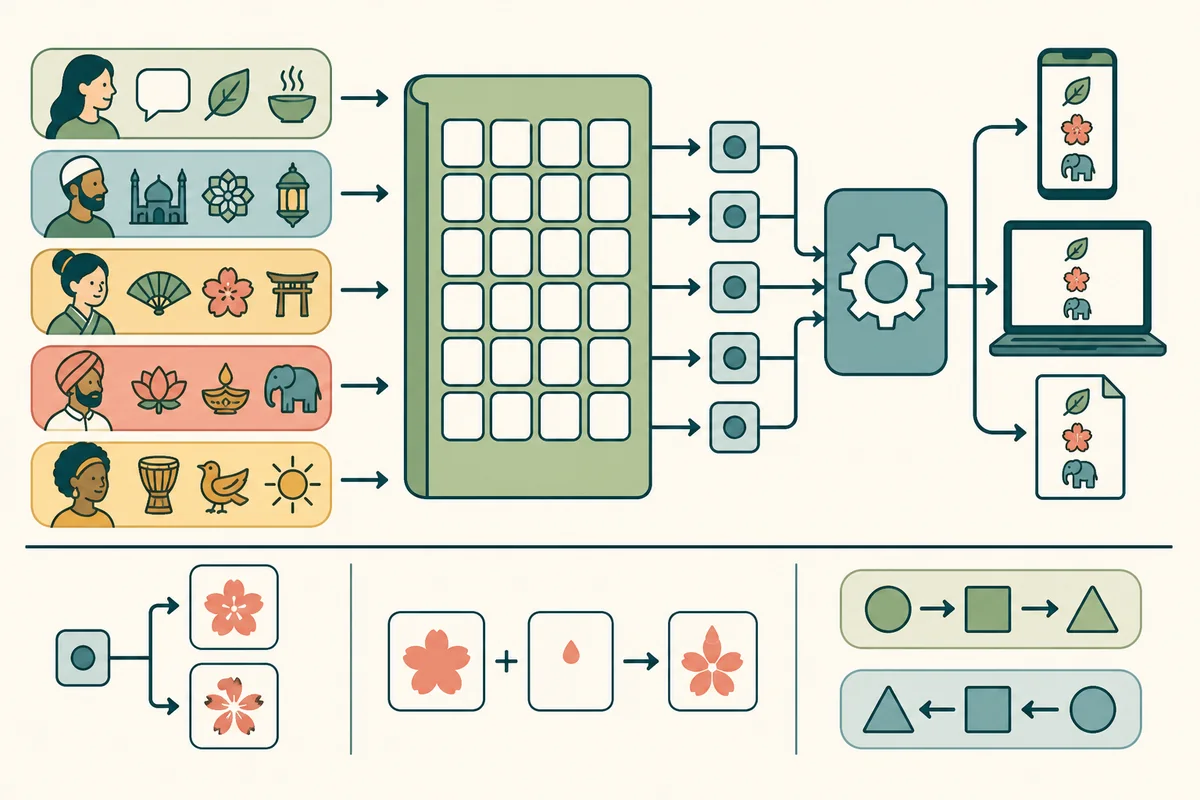
文字・符号位置・字形・書記素を分ける
意味を持つ抽象的な単位です。「同じ文字」と判断する基礎になります。
U+と16進数で表すUnicode内の位置です。一つの位置が一つのバイトとは限りません。
画面や紙に描く具体的な形です。フォント、言語、前後関係で変わります。
利用者が一文字として扱うまとまりです。基底文字と結合記号、複数の絵文字などを含められます。
符号位置は「文字の通し番号」
符号位置は通常、U+3042のように表します。この表記は「あ」という文字のUnicode内の位置を示すもので、UTF-8の保存バイト列そのものではありません。符号位置・UTF-8のバイト・フォント内の字形番号は別の値です。
ASCIIの0〜127はUnicodeの先頭128符号位置と一致します。この包含関係により、ASCIIだけからなる文字列はそのままUnicode文字列としても読めます。
一つに見える文字が複数の符号位置になる
濁点やアクセントは、完成済みの一文字として表せる場合と、基底文字にcombining character(コンバイニング・キャラクター/結合文字)を続けて表す場合があります。見た目が同じでも符号位置列が異なると、単純なバイト比較では一致しません。
normalization(ノーマライゼーション/正規化)は、比較や検索の前に表現を所定の形へそろえる処理です。NFC・NFDは正準等価性を扱い、NFKC・NFKDは互換文字の違いも畳み込みます。互換正規化は意味や見た目の区別を失うことがあるため、識別子・検索・保存で同じ方式を無条件に使いません。
異体字と絵文字は追加情報で見た目を選ぶ
同じ基底文字にvariation selector(バリエーション・セレクター/異体字選択子)を続け、特定の表示形を指定することがあります。日本語の異体字や、記号を文字風・絵文字風に表示する選択が例です。
家族、職業、肌の色、旗などの絵文字は、複数の符号位置、ZWJ、地域指示記号、修飾子を組み合わせる場合があります。文字数制限、カーソル移動、削除では、符号位置の個数ではなく書記素クラスタを意識します。
書字方向と見た目の順序
Unicodeには文字ごとの方向性と、左右の文字が混ざる文を並べるBidirectional Algorithm(バイディレクショナル・アルゴリズム/双方向アルゴリズム)があります。保存順と画面上の見た目の順が常に同じとは限りません。
双方向制御文字やゼロ幅文字は通常見えないため、ソースコード、ドメイン名、利用者IDへ紛れると読み違いを生みます。表示時に不可視文字を可視化し、識別子では許可する文字と正規化方式を決めます。
Unicodeの版と未割り当て領域
Unicodeは版ごとに文字や性質を追加します。一度正式に割り当てた文字の符号位置は原則として別文字へ使い回しません。一方、未割り当ての位置を独自文字へ勝手に固定すると、将来の標準文字と衝突します。
Private Use Area(プライベート・ユース・エリア/私用領域)は、当事者間で意味を決めて使う領域です。対応フォントや取り決めがなければ、別の環境では意図した字形になりません。
Unicodeは文字へ共通の符号位置と性質を与える標準です。保存形式はUTF-8などが担い、見た目はフォントが担います。比較・切り出し・文字数では、符号位置だけでなく正規化と書記素クラスタを確認します。
文字モデルと符号位置:The Unicode Standard/正規化:Unicode Standard Annex #15